Web制作をしていると「XPath(エックスパス)」という言葉を見かけることがあります。
XPathはWeb制作で必須の知識ではありませんが、HTMLの中から特定の要素を探したり、Webページを解析したりするときに役立つ技術です。
普段のWeb制作ではCSSセレクターを使うことが多いため、XPathをまったく使わずにWebサイトを作ることもできます。
では、XPathとはどのようなものなのでしょうか。
■ XPathとは?
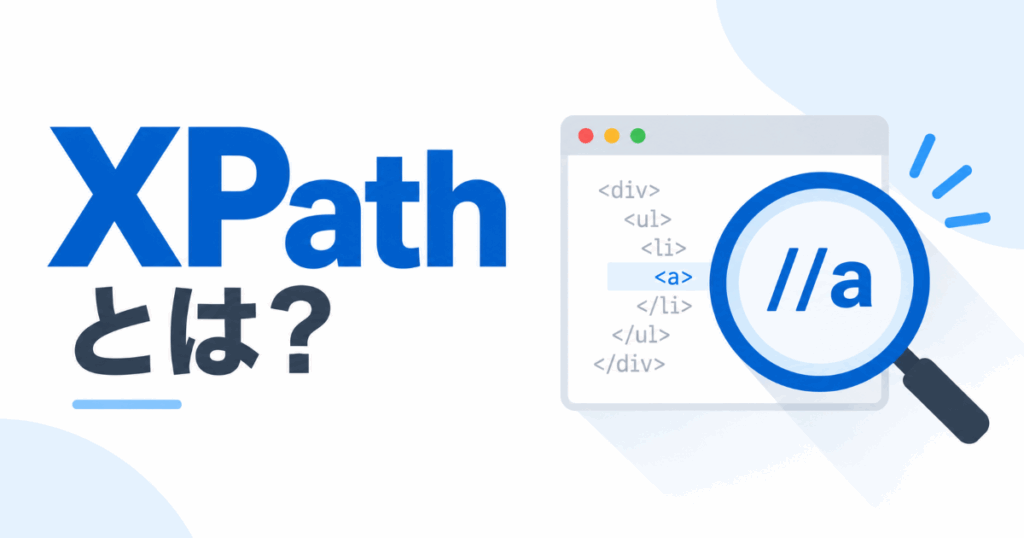
XPathとは、HTMLやXMLなどの文書構造の中から、特定の要素を指定するための方法です。
簡単に言えば、HTMLの中から目的の要素を見つけるための「住所」のようなものです。
例えば、次のようなHTMLがあったとします。
<div>
    <h1>商品一覧</h1>
    <button>検索</button>
</div>
この中にあるbutton要素をXPathで指定すると、
//button
と書くことができます。
さらに「検索」という文字が入ったボタンを指定したい場合は、
//button[text()='検索']
のように条件を追加できます。
■ 属性を使って要素を探すこともできる
XPathでは、idやclassなどの属性を条件にして要素を探すこともできます。
例えば、
<input id="search" type="text">
というHTMLがあれば、
//input[@id='search']
と指定できます。
これは「idがsearchになっているinput要素を探す」という意味です。
このように、タグ名だけでなく属性や文字など、さまざまな条件を使って目的の要素を探せるのがXPathの特徴です。
■ Web制作ではCSSセレクターを使うことが多い
Web制作で要素を指定する場合、XPathよりもCSSセレクターを使う機会の方が多いでしょう。
例えば、
<input id="search">
という要素であれば、CSSセレクターでは、
#search
と簡単に指定できます。
JavaScriptでも、
document.querySelector("#search");
のようにCSSセレクターを使って要素を取得できます。
そのため、Webサイトを制作するだけであれば、XPathを必ず覚えなければならないわけではありません。
■ ではXPathはどんなときに役立つ?
XPathは、HTMLの構造をもとに細かく条件を指定して要素を探したい場合に役立ちます。
例えば、
「特定の文字が入っている要素を探したい」
「ある要素の中にある特定の要素を探したい」
「idなどの分かりやすい属性がない要素を特定したい」
といった場面です。
Webページの解析やテスト、スクレイピングなどを勉強していくと、XPathを見る機会も増えてきます。
■ XPathを知るとHTMLの構造も見えてくる
XPathを理解するためには、HTMLの親要素・子要素といった階層構造を見る必要があります。
例えば、
html
 └ body
    └ div
       ├ h1
       └ button
というように、Webページは複数の要素が階層になって作られています。
XPathを勉強していると、「この要素はどの要素の中にあるのか」とHTMLの構造を見る習慣がつきます。
そのため、XPathそのものを頻繁に使わなくても、HTMLへの理解を深めるきっかけになります。
■ まとめ
XPathはWeb制作に必須の技術ではありません。
通常のWeb制作では、CSSセレクターだけでも多くのことができます。
しかし、HTMLの中から特定の要素を探したり、Webページを解析したりするときにはXPathが役立ちます。
最初から複雑な書き方を覚える必要はありません。
まずは、
//button
や、
//input[@id='search']
といった基本的な書き方から試してみるとよいでしょう。
「Web制作では必須ではない。でも、知っているとWebページの見方が少し広がる。」
XPathは、そんな知識の一つだと思います。